 Steve Yegge@Steve_YeggeОценка ИИ22
Ожидает перевода
Steve Yegge@Steve_YeggeОценка ИИ22Ожидает перевода
 宝玉@doteyОценка ИИ7171
SemiAnalysis 实测 Anthropic、OpenAI 等九家 AI 订阅套餐后得出,同样 200 美元,Claude 订阅折算的 Token 用量约为 OpenAI 的 5 倍。
Ожидает перевода
Anthropic Subscriptions Offer 5x+ More Value Than OpenAI Limit testing every AI subscription plan from Anthropic, OpenAI, Meta, SpaceXAI, MiniMax, Moonshot, Zdotai, Cursor, and Cognition https://newsletter.semianalysis.com/p/anthropic-subscriptions-offer-5x
宝玉@doteyОценка ИИ7171据 The Information 10 月 5 日报道,Meta 和微软都在减少员工内部使用 Anthropic 的 Claude,转向自家模型和工具。
Ожидает перевода
🚨BREAKING: Microsoft and META are aggressively cutting employee use of Claude ahead of Anthropic's IPO Microsoft has cut internal claude spend by more than 33%, nuked per-employee token budget from $100k/month to $10k/month, and forced Copilot to auto-route to cheaper models META used Claude code to build Muse, then cut active users from 60,000 to 30,000 (50% decline) after launch, and replaced it with Muse Code Palantir and Nvidia are also scaling back claude over soaring prices and data privacy fears it’s OVER…
 dex@dexhorthyОценка ИИ4040
Dex Horthy 给 @humanlayer_dev 的上下文工程建议:会话在压缩或新开时丢失上下文,应把所有上下文和决策写进 artifacts 里的文档(设计。
Ожидает перевода
宝玉@doteyОценка ИИ6767OpenAI 在 28 天更新的第 1 天宣布,通过 ChatGPT 订阅使用 GPT-6 Astra 和 GPT-6.1 Sol 时默认速度提升约 50%,用户无需改设置,两小时内生效。
Ожидает перевода
Day 1/ We have optimized the default speed to be ~50% faster across GPT-6 Astra and GPT-6.1 Sol through the subscription across all our products and partners using Sign in With ChatGPT (including OpenCode, Pi, Amp, Devin, ...). No changes needed on your end and this should be felt within the next two hours.
宝玉@doteyОценка ИИ6262OpenAI 宣布未来几周内对欧盟用户在 ChatGPT 和 Codex 生成的文字加入不可见水印,以满足欧盟《人工智能法案》要求,API 用户可在全球范围自行开启,默认关闭。
Ожидает перевода
We're expanding our approach to content provenance to include text in response to EU regulatory requirements, while recognizing the significant limitations of current text watermarking technology. Our tools already help verify whether an image or audio file was created with our models. This work builds on those efforts to help people better understand when content may have been generated or edited with an OpenAI model. In the EU, we’ll start watermarking eligible text from ChatGPT and Codex over the coming weeks to comply with the EU AI Act. Customers using our API can turn on text watermarking for select models worldwide today.
宝玉@doteyОценка ИИ7070amontlabs/lcu 把 Codex 的 Computer Use 单独拆出,让 Claude Code、Codex CLI、Pi 等 Agent 工具通过 MCP 调用。
Ожидает перевода

发现一个牛逼的东西,让任意 Agent 调用 Codex 的 Computer Use。 Codex 最强的就是 Computer Use。 但最近用 Claude Opus 5.5比较多,这样就强强联合了。 刚测试通过,安装后建议配置个 Hook,指定白名单可控制哪些 App 安装地址见评论区
GitHub 发布代码评审离线基准 ReviewBench,基于 1.039 亿个 GitHub PR 的分布特征,构建了覆盖 19 种语言、219 个公开 PR 的评测集,并公开数据集、评分规则与 LLM 评审模型配置。
Ожидает перевода
Почему это важно: GitHub 公开了 AI 代码评审基准的数据集、评分规则与评测入口,读者可据此对比不同评审智能体。
Вышел AI Hero Skills v1.3: добавлены три навыка — /implement-spec, /pr и /retro, а основной процесс, который раньше шёл от /grill-with-docs через /to-spec к /to-tickets, теперь охватывает ещё реализацию, пул-реквесты и ретроспективу.
Почему это важно: Автор достроил набор навыков до полной цепочки — от написания спецификации до пул-реквеста и ретроспективы — и рассказал, чем пришлось пожертвовать на каждом этапе и что пока сделано грубо.
 Addy Osmani@addyosmaniОценка ИИ3838
Ожидает перевода
 Shreya Shankar@sh_reyaОценка ИИ2828
Ожидает перевода
AI and GTM at Rippling: 🦄 ai that works with @vaibcode and @JohnKutay https://x.com/i/broadcasts/1XxygwaqOpyGM
宝玉@doteyИзбранное редакциейОценка ИИ8282i had a lot of fun chatting with @mattpocockuk today about how i was able to land 2,500 PRs last month! Matt is a wonderful interviewer so i think the interview turned out really interesting both of our skill plugins work great together, so i recommend giving both a try and picking the best skills that suit your workflow https://www.youtube.com/watch?v=MN9dGgmLyso
Почему это важно: На примере Лорен Тан, которая за месяц смёрджила 2500 пул-реквестов, Баоюй показывает, что отказ от построчного ревью возможен только при проверке навыками и ограничениях в виде правил, и описывает условия, при которых этот подход применим у него самого.
Google 发布 Gemini 4 Argon,其 Argon 智能体团队通过分析全集群性能遥测数据自主识别并应用内存优化,上线后释放超 300 TiB 内存,预计总节省 500 TiB 至 1 PiB。
Ожидает перевода
 geoff@GeoffreyHuntleyОценка ИИ2020
Ожидает перевода
宝玉@doteyОценка ИИ6666Ожидает перевода
New in The Atlantic: @dgrobinson resigned this week. He was among the longest-tenured employees at OpenAI—and oversaw safety reports on 12 frontier launches. He is very worried: “The time for trial and error is over.” You can read his essay here: https://www.theatlantic.com/technology/2026/10/openai-safety-team-resignation/688881/?gift=1ga2TvL-DbuHDQIcYF7oR4o908Fsjxr4NFLlsptkfP8
 Ben Holmes@BHolmesDevОценка ИИ5858
Ожидает перевода
 Matt Pocock@mattpocockukОценка ИИ4040
 Sebastian Raschka@rasbtОценка ИИ3838
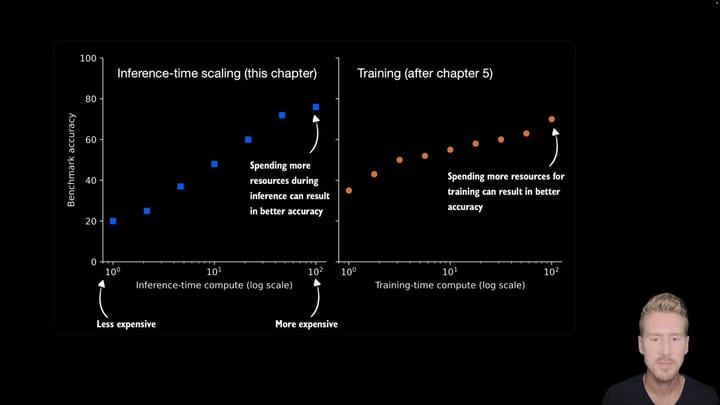
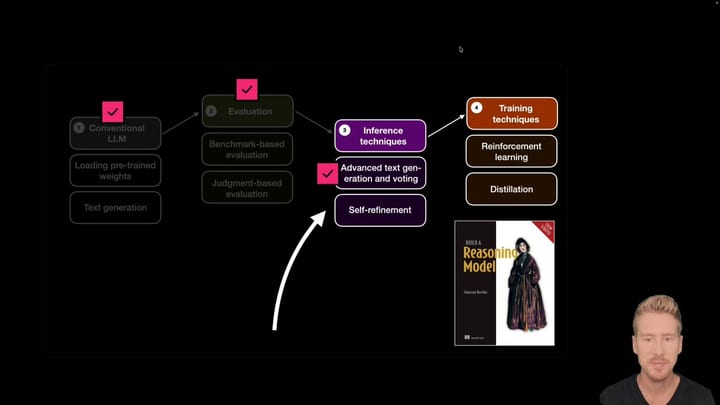
Sebastian Raschka 发布"Reasoning from scratch"系列第 6 期,讲解并实现可验证奖励强化学习(RLVR)与组相对策略优化(GRPO)。
Ожидает перевода
 Steve Yegge@Steve_YeggeОценка ИИ2222
Ожидает перевода
宝玉@doteyОценка ИИ6262剑桥大学 AI 科学与政策项目(CASP)9 月发布一篇论文,Hinton、Bengio 等 20 多位研究者联名讨论 AI 研发被自动化后是否会引发智能爆炸,Hinton 在 X 上推荐了该论文。
Ожидает перевода

The idea of an intelligence explosion caused by recursive self improvement has been around for a long time but until very recently it did not seem imminent. Now many leading researchers think it may happen quite soon. You can read our paper about it here: https://casp.ac/reports/intelligence-explosion
 OpenAI Developers@OpenAIDevsОценка ИИ3232
Ожидает перевода
宝玉@doteyОценка ИИ2626宝玉尝试用 Opus 5.5 制作吃瓜视频,素材搜集、配音(Gemini 3.8 Flash TTS,自备 API Key)全由模型完成,产出英文和中文两个版本。
Ожидает перевода
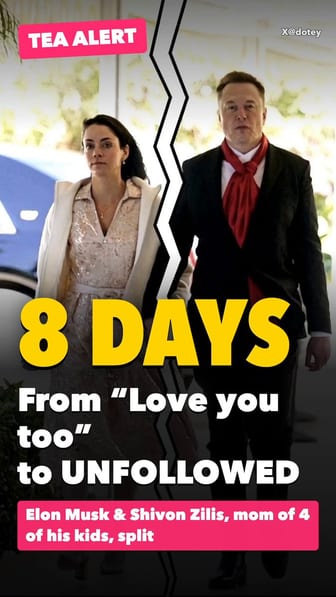

It’s hard to go from in love to let go in a week with no warning, but that’s just how it is sometimes 🤷🏻♀️ I feel happy that I got to show Elon how it feels to be deeply understood, nurtured, and peacefully loved with stability and gentleness. Given the tumultuous nature of his early life, his often tortured soul, and how hard he fights for humanity I wanted him to feel the deepest and most stable form of love this world can provide. My heart is full knowing I got to do that, and I hope it leaves a lasting good effect. We were always his safe space. A place where all of us were overjoyed to see him and one that was always full of happiness and love, not war, in contrast to his otherwise militant existence (a needed break from the battlefield where he could recharge his heart and soul before heading back out) I loved being that counterbalancing place of safety, sense of calm, and love — and delighted in bringing a smile back to his face when he was down. I will miss him dearly. I’ve loved him more than life itself and he’s taught me 100 lifetimes of knowledge and made my cup overflow with life meaning, so there is a lot of loss, but luckily we created four beautiful little loves of my life ❤️❤️❤️❤️ I am so beyond grateful for our children and they make every single day the best day of my life! I do hope and pray he and I can be great friends and coparents. I’m hurting, but care deeply about E and will always be cheering for his happiness. God speed, Elon, the world is lucky to have you.
Matt Pocock@mattpocockukОценка ИИ2828Ожидает перевода
 Andrej Karpathy@karpathyОценка ИИ5454
Karpathy 认为随着大语言模型变强,人的工作会更多上升到监督和理解层面,他分享了几个让模型输出更易读的技巧。
Ожидает перевода
Shreya Shankar@sh_reyaОценка ИИ3636Ожидает перевода
Ben Holmes@BHolmesDevОценка ИИ6666Ожидает перевода
Lovable 安全团队在 TanStack Start 中发现漏洞 CVE-2026-102989,攻击者可用特制链接让受影响应用在访客浏览器中执行非预期 JavaScript。
Ожидает перевода
Lovable 与 Microsoft 合作,让用户构建的应用发布到企业自己的 Microsoft tenant,使用工作账号登录并由 IT 统一管理。
Ожидает перевода
Sebastian Raschka@rasbtОценка ИИ2222Ожидает перевода
Thorsten Ball 在 Register Spill 的 Joy & Curiosity #101 中提出,框架已不再是最大的开发者生产力杠杆,AI 智能体比它大一百倍,语法和工具易用性也不再重要。
Ожидает перевода
GitHub Copilot 应用中的 canvas(画布扩展)是一种用户与智能体共享的可定制界面,可做成看板、issue 分诊板、发布清单或仪表盘。在 agent 会话中输入 /create-canvas 并用自然语言描述工作流,智能体即可生成界面并在右侧面板打开,无需手写代码或调整布局。
Ожидает перевода
 Boris Cherny@bchernyОценка ИИ6060
Ожидает перевода
Claude Tag in Slack can now use your personal connectors! You can now securely access that Drive doc, Salesforce account, or Warehouse table that you have personal access to right where the work happens. Avail. on Teams today and Enterprise next week https://claude.com/blog/claude-tag-now-supports-personal-connectors-in-channels
GitHub Copilot 应用推出 canvas,一种运行在应用内、无浏览器外壳的全栈小应用,可与 Copilot 智能体双向通信,也能在本地执行代码。作者认为 chat 只适合作为通用兜底界面,用户明确任务时更该让智能体生成可复用工具,例如用 canvas 管理 Winget 包或直接操作 SQLite 数据库,避免把 token 浪费在“stage and commit”这类操作上。
Ожидает перевода
Lovable выпустила Chats — агента, который работает на уровне рабочего пространства, может вести диалог между проектами и запускать сборку. После подтверждения изменений он передаёт задачу builder-агенту внутри проекта и возвращает ход выполнения обратно в диалог.
Почему это важно: Lovable раскрыла трёхуровневую архитектуру Chats: траектории, входящие сообщения и активация. Её можно перенести на собственную оркестрацию мультиагентных систем.
Lovable 聊天功能现已免费开放,Free、Pro 和 Business 工作区每天都有免费聊天额度。用户可以让它评估该做哪个创意、把客户反馈整理成计划,或分析已上线应用的代码和 Lovable Cloud 数据库用量。聊天在生成图片、视频或转交 Plan、Build 时仍照常消耗 credits,当前聊天定价(含每日免费额度)适用至 2026 年 10 月 31 日。
Ожидает перевода
GitHub Copilot 应用重建了 pull request 视图,用一个含 2,200 个文件、超 100 万行改动、400 多条行内评论的开源 PR 做验证。代码行沿用“绘制前高度已知”的虚拟化方案,评论等动态块则改为懒测量、高度有界,并把文档高度拆成确定性的代码高度与动态块高度两个独立域,避免滚动跳变。
Ожидает перевода
Steve Yegge@Steve_YeggeОценка ИИ2222Ожидает перевода
Cursor выпустил двух ботов — Rollouts и Security Review, доступных для Team и Enterprise.
Почему это важно: Официально описаны процессы мониторинга и проверки безопасности для этих двух ботов — читатели могут оценить, можно ли встроить их в существующий конвейер доставки.
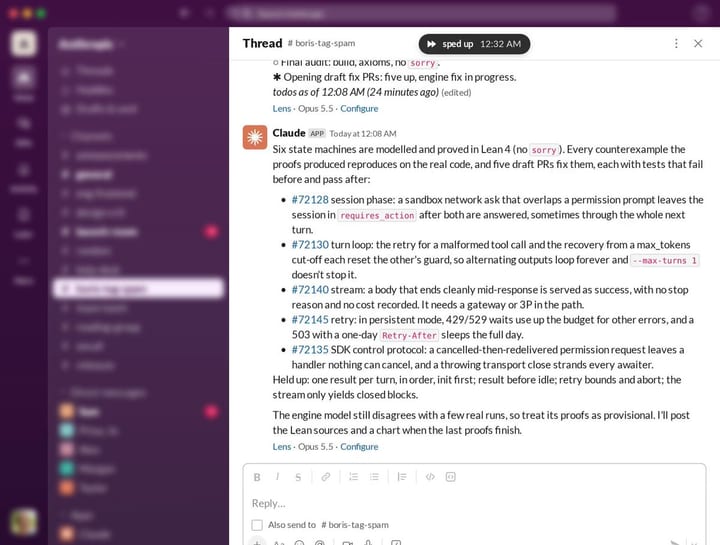
Boris Cherny@bchernyОценка ИИ5858Boris Cherny 用 Opus 5.5 配合 Lean 对 Claude Agent SDK 做形式化验证,几段简短提示词换来 16 个 PR,修复了多个 bug 和竞态条件。
Ожидает перевода
Lovable выпустила Opus 5.5; по заявлению компании, результаты сопоставимы с Opus 5, но число шагов до завершения сократилось на треть–половину. На внутреннем бенчмарке Lovable Opus 5.5 сравнялся с Opus 5 в двух задачах — сборке от 0 до -1 и итеративных правках кода — и превзошёл его на 4%–6% по дисциплине проверки; при всех уровнях интенсивности рассуждений число шагов на задачу снизилось на 26%–57%, а объём входных токенов — на 21%–59%; различия значимы при доверительном уровне 95%.
Почему это важно: Lovable официально приводит данные сравнения Opus 5.5 и Opus 5 по числу шагов и токенов — по ним можно оценить реальное изменение эффективности сборки.