Методика оценки и трассировка открытых моделей Cline
Оригинальный заголовок: Open-sourcing evals for open-weight agents
Cline открывает методику оценки своих открытых моделей и выкладывает для скачивания и анализа трассировки и результаты «восхождения», стоившие больше тысячи долларов. В статье приводится Hill Climber's Checklist — пять эвристик: задать метрику-«Полярную звезду», измерить шум, разложить режимы отказа по задачам, моделям и поставщикам, не считать по умолчанию, что чем больше рассуждений, тем лучше, и сохранять закрытый оценочный набор.
Cline публикует методику оценки и трассировки на тысячи долларов и даёт пять переносимых эвристик «восхождения», полезных командам, которые собирают собственный harness.
Предисловие

С выходом новых моделей вроде Fable и Gpt-5.6 Sol становится всё очевиднее: модели с закрытыми весами превращаются в очень дорогой товар, и мы оказываемся во власти передовых лабораторий, которые решают, что нам использовать и сколько это будет стоить.

В большинстве подписок на ИИ-агентов для разработки нет прозрачных цен, а лимиты кредитов могут соответствовать разному количеству токенов в зависимости от дня. Даже компании, которые активнее всех используют ИИ и выжимают максимум токенов, теперь видят, что у них есть два пути: либо перейти на модели с открытыми весами по умолчанию, либо просто сделать собственный harness ради эффективности.
В Cline мы заметили необычный рост расхода токенов на моделях с открытыми весами за последние несколько месяцев — по понятным причинам: цена и качество улучшились настолько, что такие модели сравнялись с моделями с закрытыми весами или даже превзошли их.
Ранжировав модели по нашему использованию, мы увидели, что пять самых используемых моделей в Cline сейчас — все с открытыми весами.
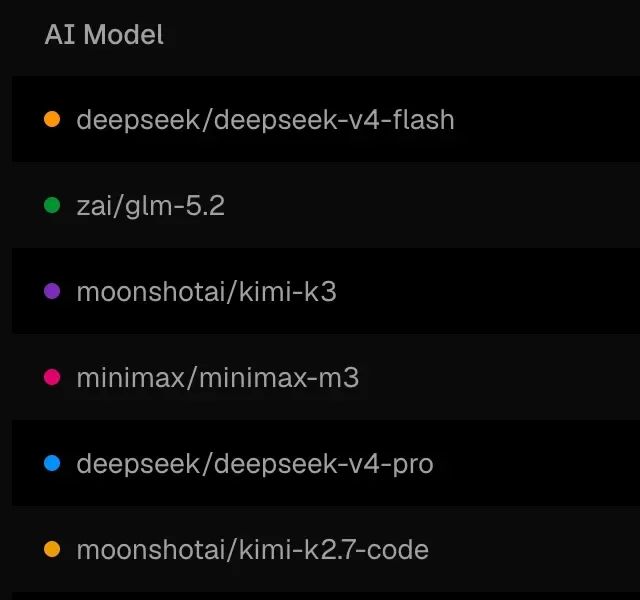
Поэтому мы начали разбираться, как Cline показывает себя на моделях с открытыми весами. Большинство пользователей Cline — избалованные SOTA-максималисты по токенам, которые сжигают миллиарды токенов на новейших передовых моделях. Но все мы всё чаще экспериментируем с моделями с открытыми весами, учимся с ними работать и улучшать их.
Наш новый SDK позволяет измерять средний размер токенов в запросах Cline, и вывод оказался неутешительным: наши запросы оказались на 20–30% тяжелее, чем публично заявленные средние показатели самых эффективных harness. Да, на большинстве моделей с открытыми весами у нас были оценки уровня SOTA, но дополнительные затраты на токены не делали это приемлемым.
О чём этот блог
Я прочитал десятки блогов про оценки и понял, что большинство из них — самолюбование и максимизация бенчмарков. Этот блог будет другим. Я проведу вас по «Чек-листу покорителя вершин»: пять эвристик для восхождения и подходы к ним в зависимости от ваших целей. В конце я оставлю вам результаты и трейсы восхождений на сумму более тысячи долларов. Вы сможете скачать и изучить эти трейсы, чтобы найти тонкие закономерности, прогнав через них своих агентов.
Как мы проводим оценки?
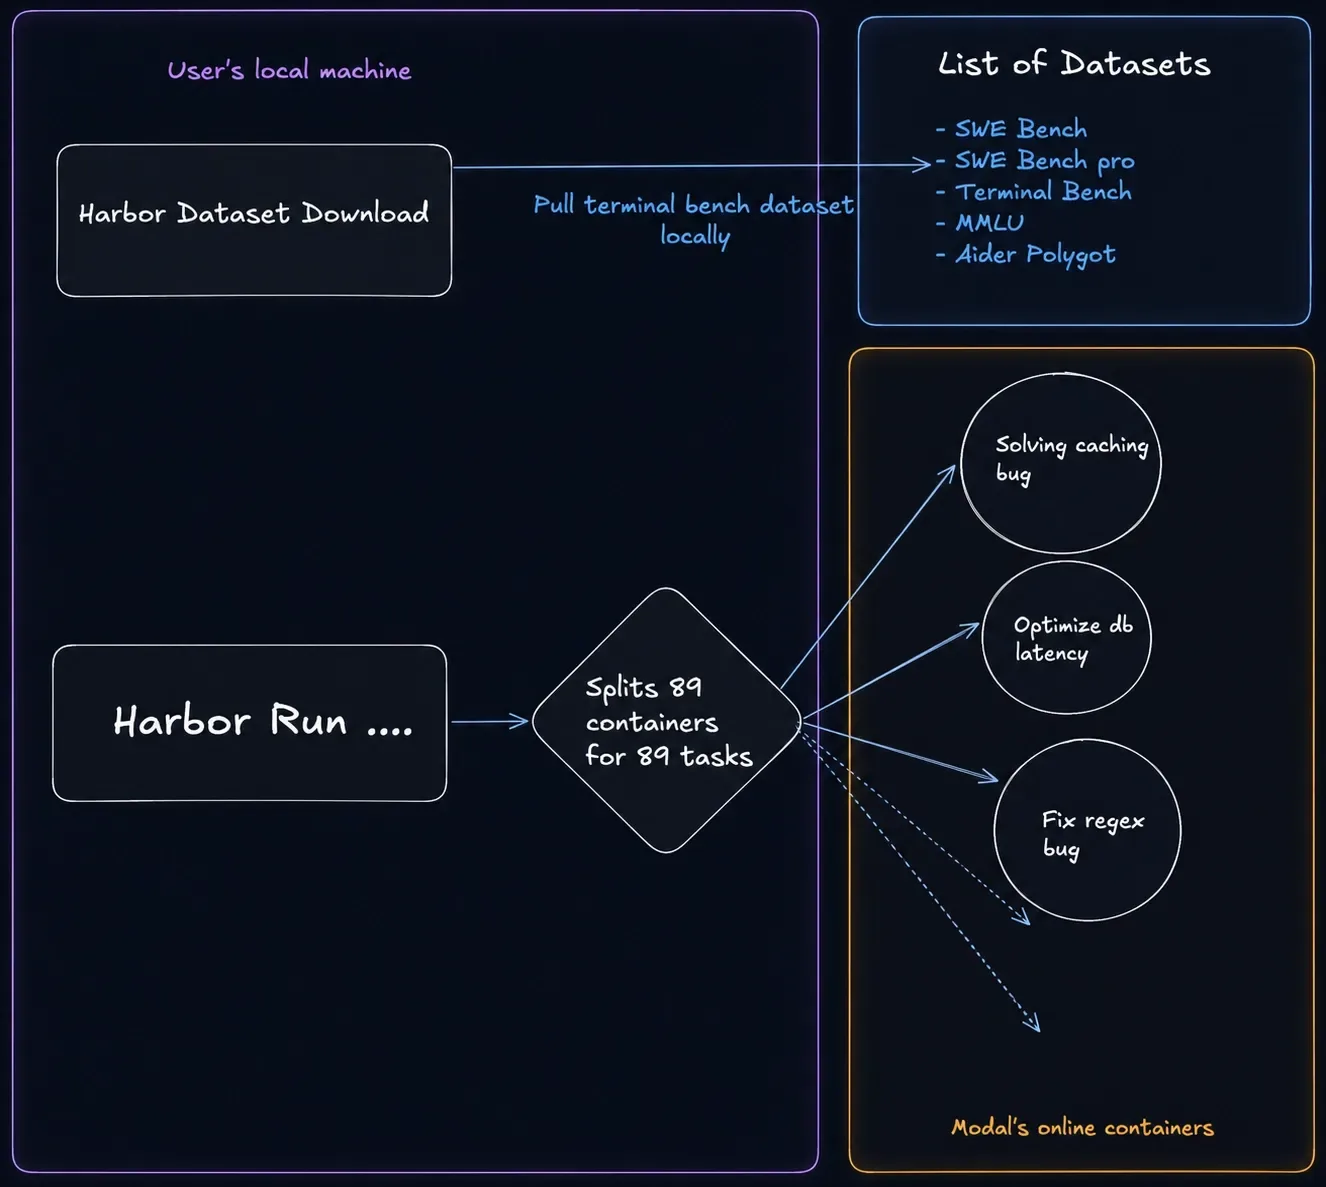
Мы используем Harbor. Это широко используемый фреймворк для оценки агентов, созданный авторами Terminal-Bench. Он берёт на себя управление песочницами, цикл работы агента и мониторинг прогонов, чтобы можно было запускать оценки.
Harbor позволяет запускать множество параллельных оценок через Modal на одном и том же наборе задач по программированию из 89 задач — Terminal Bench, — так что можно проводить длительные прогоны оценок на разных harness для ИИ-агентов для разработки и быстро получать сводные метрики: входные токены, кэшированные токены, выходные токены, чистая стоимость, использованные вызовы инструментов и т. д.
Что мы оптимизируем при оценках?
Проводя оценки, нужно рассматривать их как задачи многокритериальной оптимизации, где вы балансируете между разными, конфликтующими осями. Цель — найти правильное сочетание целей, которые стоит оптимизировать.
Вот несколько примеров конфликтующих целей:
- Стоимость против интеллекта
- Уровень рассуждений против эффективности по токенам
- Время решения против оценки на бенчмарке
- Эффективность по токенам против оценки на бенчмарке
Во всех этих случаях хочется оптимизировать обе стороны конфликтующей цели, но нужно выбрать правильный баланс. Я легко наберу 91% на Terminal Bench, если включу максимальный режим Fable, но это будет стоить в 10 раз дороже, чем Kimi K3. Так стоят ли лишние 3% в 10 раз большей чистой стоимости прогона?
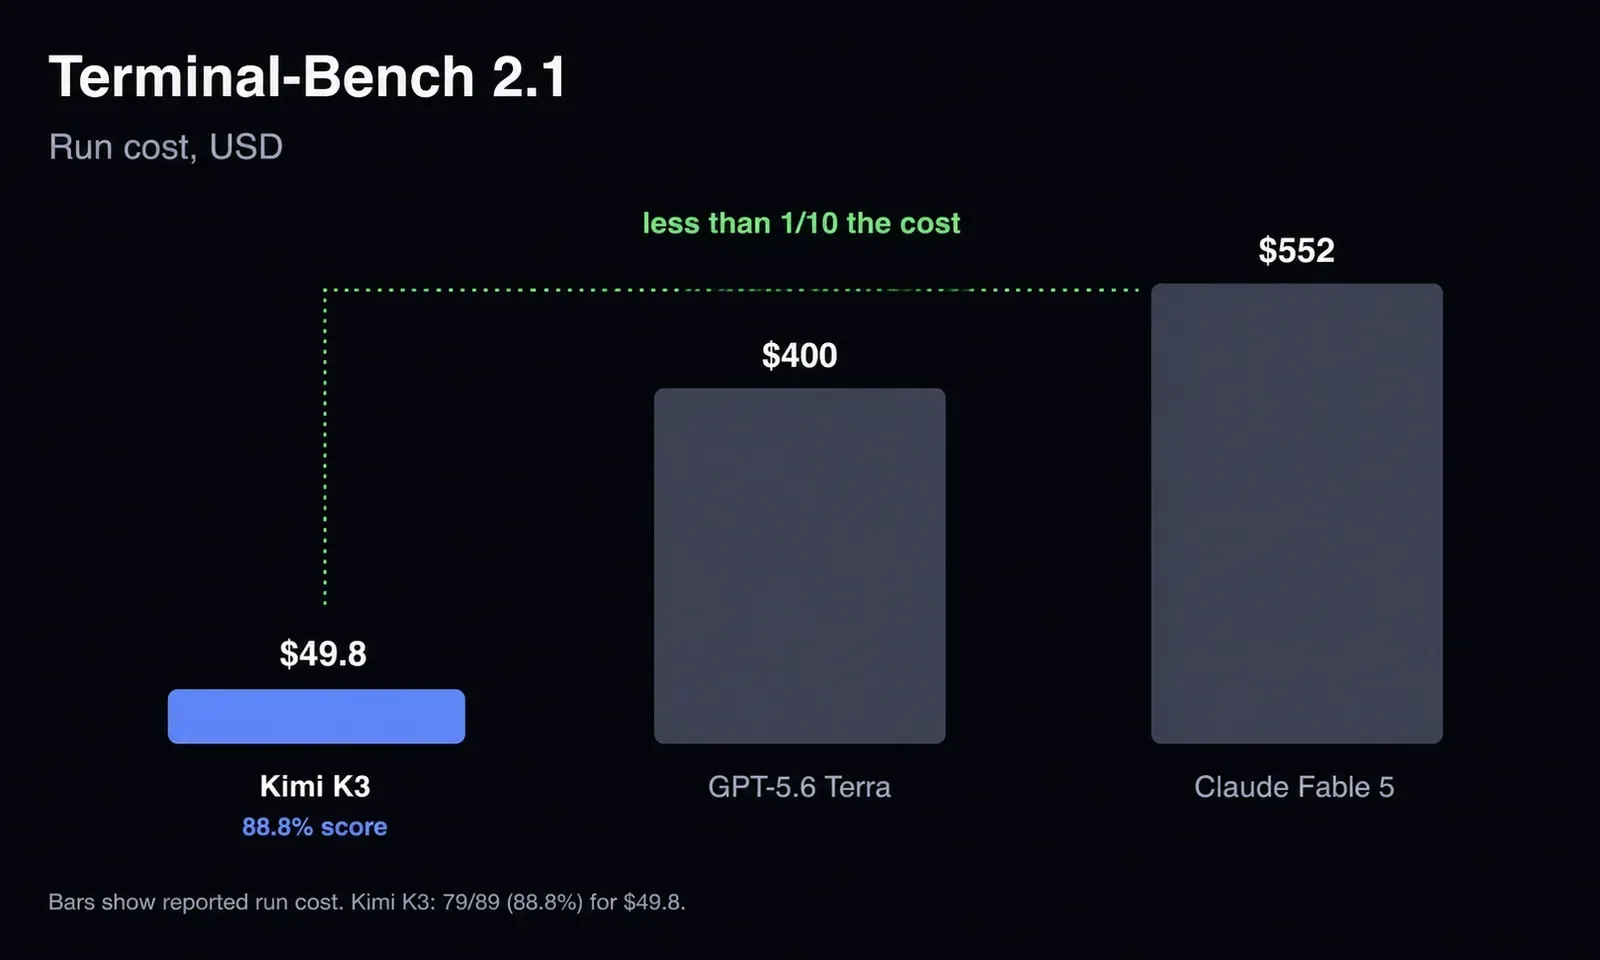
Большинство оптимизаций в оценках связано именно с таким конфликтом, где приходится выбирать, за что бороться. Иногда вы улучшаете одно за счёт другого, и нужно тщательно решить, что лучше подходит для вашего сценария. Для нас в Cline максимальная производительность всегда в приоритете, но сразу за ней идёт забота о том, чтобы пользователи получали максимум за свои деньги — могли решить как можно больше задач при минимальных затратах. Мы занимаемся кэшированием и оптимизацией работы с токенами, а также предлагаем пакетные решения вроде Cline Pass, где мы даём вам инференс в комплекте по низкой цене.
Теперь об эвристиках. Их пять, и вместе они образуют «Контрольный список восхождения на холм».
Определите метрику «Северной звезды»
Метрика «Северной звезды» защищает вас от двух основных ошибок при восхождении на холм:
- Переусердствовать: из модели можно выжать лишь определённый максимум, и за этой точкой вы просто топчетесь на месте.
- Недоработать: вы оставили улучшения на столе, потому что ваш харнесс ограничивал модель.
Смысл метрики «Северной звезды» — найти золотую середину: результат, достаточно высокий, но без чрезмерных затрат времени и усилий на переоптимизацию. Большинство моделей лучше всего показывают себя в собственном харнессе, потому что модель и харнесс связаны друг с другом — и через использование вызовов инструментов, и через оптимизации после обучения.
Cline строит общий харнесс для всех, и если вы это читаете, то, скорее всего, делаете агента, который работает с любой моделью. Поэтому когда оценка новой модели оказывается намного ниже числа в её системной карточке, нам нужно оптимизировать. Если расхождение составляет 1–-3%, обычно не стоит гнаться за лучшим результатом. Но если результат сильно отстаёт от SOTA, значит, пора браться за работу. Как правило, мы стремимся набрать столько же, сколько лучший публично доступный харнесс для этой модели.
Оцените уровень шума
Один из показателей хорошей оценки — дисперсия. На значимых задачах одна и та же модель, харнесс и конфигурация должны давать некоторый разброс в количестве пройденных тестов. Сложные, хорошо поставленные задачи ставят модели на границу прохождения и непрохождения, поэтому одинаковые повторные запуски дают реальный разброс результатов. Именно этот разброс делает оценку различающей и даёт RL в стиле GRPO сигнал для обучения. Но сначала нужно исключить нестабильность как причину — поэтому мы часто перезапускаем оценку и публикуем распределение.
Вот несколько примеров разброса на стороне Cline
| Модель | Конфигурация | Разброс |
|---|---|---|
| minimax-m3 | Та же сборка, 5 повторных запусков | 43.8%–56.2% (±11 задач); два запуска подряд дали 11 задач вверх и 18 вниз |
| deepseek-v4-pro | Та же сборка, 2 запуска | 44.9% против 53.9% (22 задач изменились, часть в плюс, часть в минус) |
| glm-5.1 | Та же сборка, 3 повторных запуска | 46.1% / 47.2% / 49.4% (24% задач изменились) |
| deepseek-v4-flash | Та же сборка, 3 повторных запуска | 38.2% / 44.9% / 48.3% (±5 задач, число ошибок менялось как 20/17/9) |
| glm-5.2 | Та же сборка, много повторных запусков | 56.2%–74.2% (~16 задач) |
Учтите: причину разброса нужно выявить. Если нестабильность инфраструктуры на вашей стороне — это проблема, которую необходимо решить. Причиной может быть что угодно: от провайдера с низкой производительностью до нестабильных виртуальных машин. Вы должны сделать всё возможное, чтобы устранить разброс в оценочных запусках и быть уверенными, что одинаковые значения конфигурации действительно соблюдаются.
Разберите режим отказа
Когда чистый балл оценки выглядит неправильно, нужно разрезать и разложить его по частям, пока не найдёшь, где именно кроется проблема. В Terminal-Bench, где 89 задач, часто удаётся сузить круг потенциальных улучшений, разбив проблему определённым образом.
Разбить её можно тремя способами, в порядке приоритета: по задаче, по модели и по провайдеру.
Задача
Лучший первый способ разобрать паттерны сбоев — по задачам. У нас была проблема раздувания токенов: некоторые модели тратили невероятное их количество, и первым порывом было отнестись к этому как к глобальной проблеме — мол, Cline тратит слишком много токенов, значит, надо чинить расход токенов везде. Задним числом это была неверная рамка.
Когда мы сравнили свои трассировки с трассировками агентов, у которых такого раздувания не было, разрыв оказался распределён по бенчмарку неравномерно. Он сосредоточился на небольшом наборе задач. В одном запуске около 250K токенов пришлось всего на 15 из 89 задач, а суммарно набралось 450 миллиона токенов, то есть примерно 55% токенов пришлось всего на 17% задач.

Часто очень трудно понять, что не так именно с определённым набором задач, а не с остальными. Помимо расхода токенов можно отдельно разобрать их сбои.
Вместо того чтобы смотреть на них вручную, можно попросить свой агентный каркас пройтись по трассировкам разными субагентами и выдать тебе сводку. По-моему, это гораздо лучше, чем разглядывать трассировки своими глазами.
Так что вместо попыток починить раздувание токенов во всех 89 задачах мы могли бы вычленить эти задачи, посмотреть, что агент делает по-другому, а затем, после внесения исправлений, провести финальную проверку на всех задачах.
Итак, действовать нужно так:
- Сначала выяви проблемные задачи.
- Точечно вноси исправления и перезапускай их на выбранных задачах.
- Когда улучшение подтвердилось, запусти всё целиком для проверки, чтобы убедиться, что исправление не ломает другие задачи.
Модель
Если ты делаешь общий каркас, ты не будешь поддерживать совершенно отдельный путь в коде и поток системных промптов для каждой модели. Большая часть каркаса общая: логика компактизации, вызовы инструментов, работа с контекстом, computer use и субагенты обычно работают по схожей логике. Плата за общий каркас — улучшения для одной модели могут ухудшить другие.
Классический пример — эксперимент, в котором мы добавили усечение раздувания инструментов, чтобы решить проблему раздувания токенов в моделях MiniMax.
| Модель | До → с исправлением → итоговый стек | Направление |
|---|---|---|
| minimax-m2.7 | 32.6% → 41.6% → 46.1% | +13.5 балла ▲ |
| glm-5.1 | 48.3% → 52.8% → 57.3% | +9.0 балла ▲ |
| deepseek-v4-pro | 47.2% → 47.2% → 42.7% | −4.5 балла ▼ |
| deepseek-v4-flash | 48.3% → 43.8% → 41.6% | −6.7 балла ▼ |
Одним ограничителем усечения мы улучшили MiniMax M2.7 на 13.5 балла и GLM-5.1 на 9 баллов. Но при этом навредили DeepSeek Flash на 6.7 балла и DeepSeek Pro на 4.5. То есть одно и то же изменение дало противоположный эффект на разных моделях.

Само усечение было простым: любой вывод инструмента больше 50K обрезался до 8K — сохранялись начало и конец, а середина удалялась. Это было чистое удаление без сжатия, так что ничего не суммировало удалённое. При повторном чтении того же файла возвращался тот же усечённый вид, и модель никак не могла восстановить пропавшую середину. И всё же это помогало, потому что агент пересылает всю свою историю на каждом шаге. За одно огромное наблюдение приходится платить в каждом последующем запросе, так что его обрезка сохраняла форму диалога разумной, поддерживала локальность кэша и снижала стоимость.
Поможет ли это конкретной модели — зависит от того, как она обрабатывает длинный контекст. GLM и MiniMax теряются в середине длинного зашумлённого вывода, поэтому удаление середины улучшило их результаты: на +13.5 и +9 балла соответственно. DeepSeek рассуждает по основной части и хвосту длинных выводов инструментов, поэтому удалённая середина содержала состояние, которое модель всё ещё использовала, а вернуть его было нельзя — и результаты упали на 6.7 и 4.5 балла. Получается, один и тот же рычаг даёт противоположный эффект в зависимости от модели.
Чтобы это исправить, есть два варианта:
A. Сделать изменения достаточно универсальными, чтобы они работали для большинства моделей.
B. Использовать совершенно разные алгоритмические подходы для разных моделей. Минус в том, что придётся бессрочно поддерживать соответствия между моделями и механизмами.
Мы много раз шли по пути B: использовали семейства промптов для разных моделей, чтобы выжать лучшее из разных семейств, — но только после тщательно продуманного рефакторинга.
В вашем случае нужно найти компромисс. Какие модели стали лучше? Какие хуже? И приемлема ли эта регрессия для сценария, который вам действительно важен? Универсально лучшего харнесса не существует. Есть только то, что лучше для конкретной модели, провайдера и сценария, и это придётся выяснять самому.
Провайдеры
Хотите верьте, хотите нет, но одна и та же модель у разных провайдеров — не одна и та же модель. Многие передовые модели с открытыми весами обслуживают несколько провайдеров, например CoreWeave, Baseten и Fireworks. Обычно считают, что разница между провайдерами — только в квантизации, но это лишь малая часть истории.
Провайдеры различаются коэффициентом попадания в кэш, квантизацией, TTFT, задержкой и ценой, и каждый из этих факторов влияет на метрики ваших оценок. Когда мы подключаем нового провайдера для маршрутизации трафика, мы проверяем, что его оценка не хуже, чем у остальных. Можно одновременно иметь хорошую оценку и плохой коэффициент попадания в кэш. Если не запускать оценки, вы не узнаете, что пошло не так.
Вот конкретный пример из наших запусков GLM-5.2 на одной и той же сборке у двух провайдеров:
- CoreWeave при среднем уровне рассуждений: 66/89 задач, 74.2%.
- OpenRouter при общей маршрутизации и среднем уровне рассуждений: 55/89 задач, 61.8%.

Один только маршрут стоил 11 задач, так что мы научились отслеживать каждый маршрут провайдера как отдельную запись. Мы также наблюдали разницу до 2x в чистых токенах и коэффициенте попадания в кэш между провайдерами — из-за этого запуск за $20 может превратиться в запуск за $43 при той же оценке.
Мораль: с разными провайдерами открытых весов нужно быть осторожным и проверять их оценками, прежде чем переключать трафик.
Больше размышлений — не всегда лучше
Когда речь о размышлениях, обычно считается, что чем больше, тем лучше. Это не обязательно так. Усилие на рассуждения — не бесплатный регулятор интеллекта. Оно стоит дороже и иногда снижает оценку.
Результат Opus 5 на FrontierCode — классический контрпример к идее, что больше размышлений даёт лучший результат.
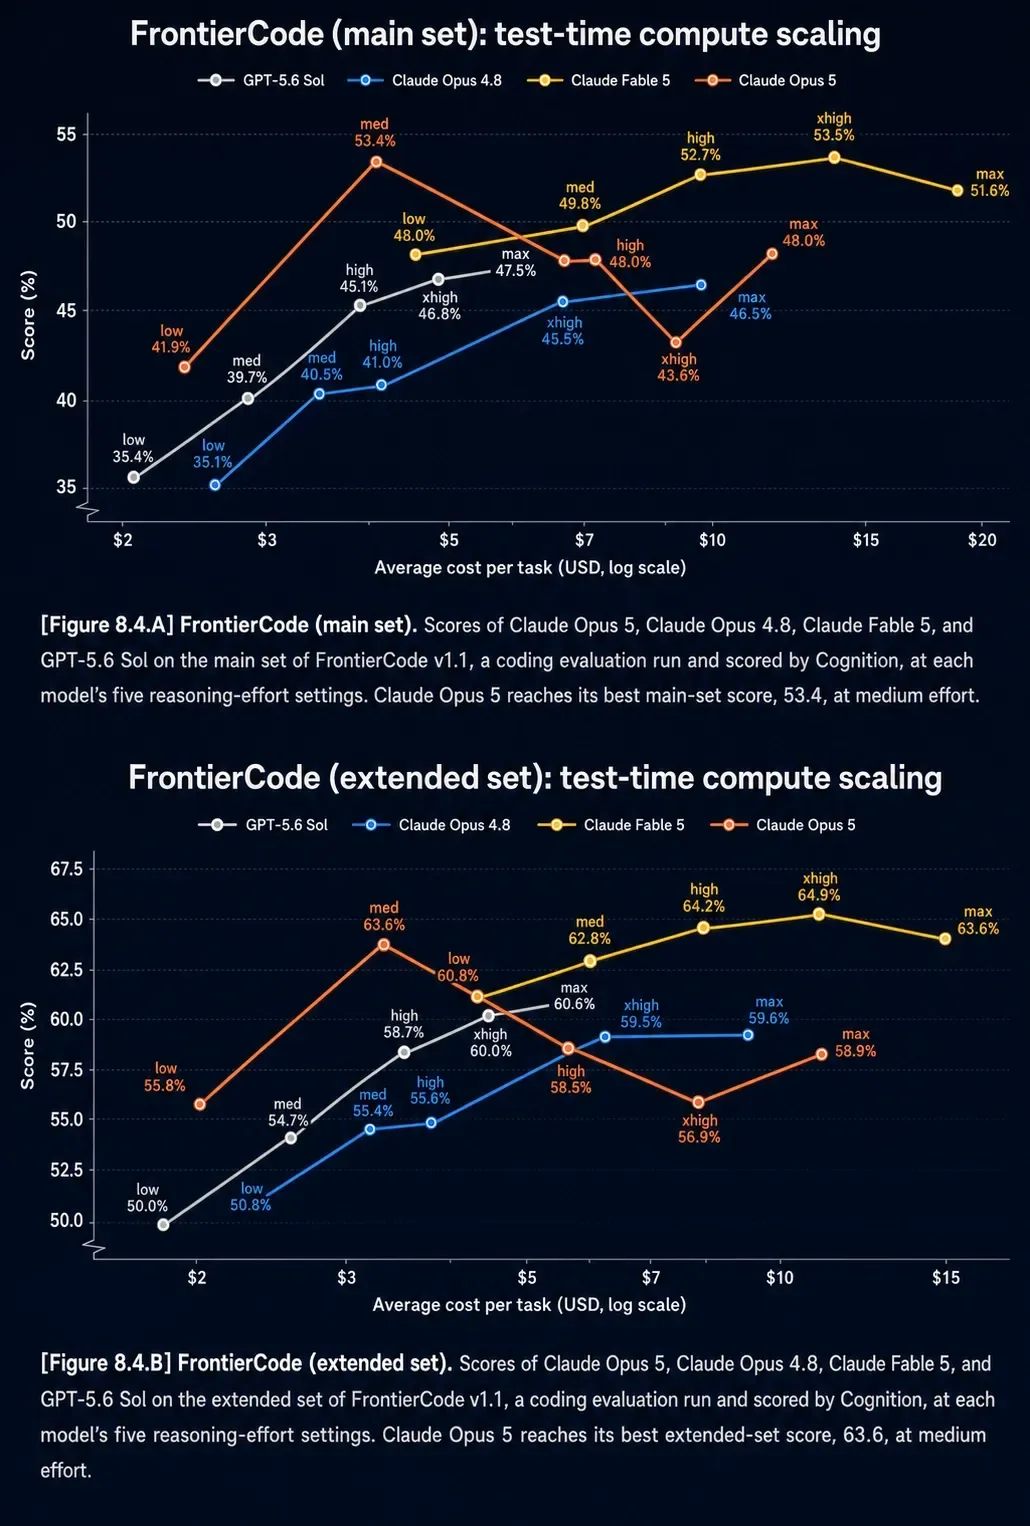
Видно, что средний уровень размышлений обошёл высокий, сверхвысокий и максимальный на основном разбиении.
Это значит, что нужно прогнать всю матрицу. Модель, провайдер, харнесс и распределение задач определяют, где находится полезный бюджет на рассуждения. Больше размышлений может быть дороже и менее эффективно, а иногда дополнительный прирост оценки от большего числа размышлений не оправдывает рост цены, потому что токены рассуждений — очень дорогие выходные токены.
Держите приватный набор
Многие компании делают собственные оценочные наборы, и вам тоже стоит этим заняться, если есть возможность. У многих методов оценки есть проблема: модели начинают «вознаграждать себя» — например, просто ищут ответы в интернете; бывает и так, что оценочные наборы «случайно» попадают в обучающую выборку.
Лучший способ тестировать модели — иметь закрытый набор стоящих задач с надёжными верификаторами. Если хотите сделать хороший бенчмарк самостоятельно, вот отличный блог-пост от команды Terminal-Bench.
Прощальное замечание
Нет лучшей практики в прикладном ИИ, чем работа с оценочными наборами. Она поможет понять, почему ваши агенты ошибаются и как выжать из модели максимум, а ещё покажет компромиссы, которые соответствуют целям вашей команды.
В конечном счёте оценка — это метод проб и ошибок. Пока вы не попробуете, не пройдёте несколько итераций и не наделаете кучу ошибок, вы так и не научитесь делать это хорошо. Как и обещал, прикладываю десятки трассировок запусков оценки, чтобы вы увидели, как Cline работает на разных моделях; можете запускать агентов на этих трассировках, чтобы разобраться в режимах сбоев и сделать выводы.
Оценка — дело сложное, и эти эвристики — хорошая отправная точка. Если заниматься этим достаточно долго, можно даже написать рекурсивные самосовершенствующиеся промпты и полностью автоматизировать процесс улучшения оценочных наборов.
Источник: Cline · Blog · cline.ghost.io