 Boris Cherny@bchernyОценка ИИ5858
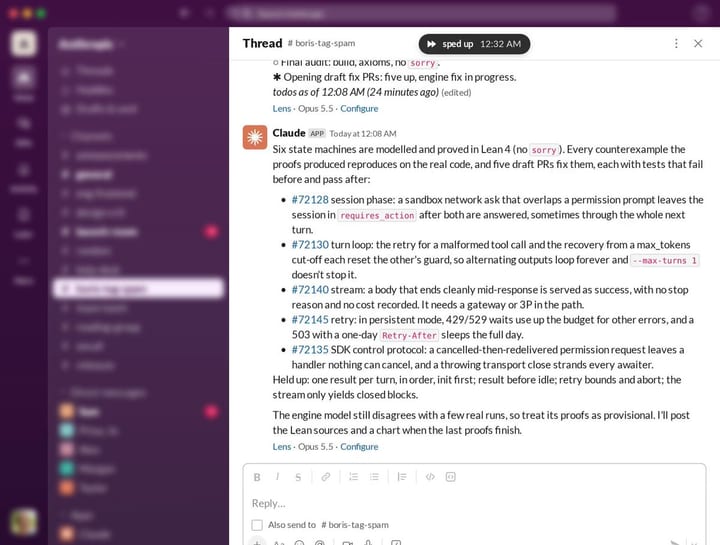
Boris Cherny 用 Opus 5.5 配合 Lean 对 Claude Agent SDK 做形式化验证,几段简短提示词换来 16 个 PR,修复了多个 bug 和竞态条件。
Ожидает перевода
 Boris Cherny@bchernyОценка ИИ5858
Boris Cherny 用 Opus 5.5 配合 Lean 对 Claude Agent SDK 做形式化验证,几段简短提示词换来 16 个 PR,修复了多个 bug 和竞态条件。
Ожидает перевода
Lovable выпустила Opus 5.5; по заявлению компании, результаты сопоставимы с Opus 5, но число шагов до завершения сократилось на треть–половину. На внутреннем бенчмарке Lovable Opus 5.5 сравнялся с Opus 5 в двух задачах — сборке от 0 до -1 и итеративных правках кода — и превзошёл его на 4%–6% по дисциплине проверки; при всех уровнях интенсивности рассуждений число шагов на задачу снизилось на 26%–57%, а объём входных токенов — на 21%–59%; различия значимы при доверительном уровне 95%.
Почему это важно: Lovable официально приводит данные сравнения Opus 5.5 и Opus 5 по числу шагов и токенов — по ним можно оценить реальное изменение эффективности сборки.
Paper Compute 工程师用 TypeSafe 的 Jev 做智能体会话标签实验,在 1,781 条工程师对话轮次上,Jev 1.13.0 中位响应 188 ms,比 GPT-4o mini 的 1,023 ms 和 Claude Haiku 4.5 的 1,050 ms 快约 5.4 倍和 5.6 倍,本地 Qwen3 8B 为 2,311 ms。
Ожидает перевода
Foremerge 是一个位于 git 之上的本地协调层,不改变 git 和 worktree 的工作方式。每个智能体在编辑前先发布意图和将要改动的范围及操作,第二个智能体发布时若与已有意图冲突会返回 HIGH 级别的 destructive_vs_additive 提示,检测是确定性的,不依赖评审模型读代码。
Ожидает перевода
文章用概率模型算出,失败率 1% 的测试要跑 299 次才有 95% 概率被发现,而单次重跑有 99% 概率变绿,因此重跑通过几乎不提供信息。作者建议智能体循环中不要用重跑覆盖原始失败记录,并把已知不稳定测试单独标记,例如用 pytest-rerunfailures 的 @pytest.mark.flaky(reruns=n) 按测试标注,而不是全局 --reruns 3。
Ожидает перевода
作者提出 AI 生成代码的测试应从任务契约出发,攻击生成代码容易忽略的边界,包括无效输入、缺失身份、错误权限、空值与最大值、重复投递、重试、并发请求、schema 兼容、部分失败和回滚,并给出一张覆盖契约、输入、身份、权限、持久化、重复、重试、并发、迁移、外部服务、可观测性和回滚的失败矩阵。
Ожидает перевода
Эдди Османи предлагает при внедрении ИИ-агентов в легаси-кодовую базу (brownfield) сначала сделать скрытые ограничения видимыми, а дешёвые изменения — надёжными. Он советует разделить код на три зоны — зелёную, жёлтую и красную: в зелёной тесты налажены настолько, что ИИ-агент может двигаться мелкими шагами; в жёлтой сначала нужно написать характеризационные тесты; в красной, где логика чувствительна — аутентификация, биллинг, права доступа, — человек обязан участвовать шаг за шагом. Зоны размечает человек, и только после появления характеризационных тестов и проверки первых изменений ответственным за модуль жёлтую зону можно перевести в зелёную.
Почему это важно: Автор раскладывает ограничения при внедрении ИИ-агентов в старую кодовую базу на конкретные правила — зоны, характеризационные тесты и единицы миграции — и приводит данные о миграции нескольких компаний для сравнения.
作者用 Astra、Fable 和 Opus 连续数天规划编码一个数万行代码的智能体项目,在 e2e 测试中发现 MCP 工具的响应被重复输出(结构化加普通文本),这个缺陷一直漏到最终验证阶段。
Ожидает перевода
Anthropic 的 Boris Cherny 表示,Claude 编写的生产代码应比人类编写的代码有更高门槛。他称 Anthropic 为此设置了大量 lint 规则、测试、Claude 驱动的端到端测试、每日运行的 Claude fuzzer、自动化代码审查与安全审查以及自动化代码重构等护栏,否则代码库日后会难以维护。
Ожидает перевода
作者提出一套以证据闭环为核心的 AI 编码工作流,把 issue 契约、起始状态记录、失败复现、窄 diff、命令日志、评审记录和发布证据串成可被质疑的产物链,而不是依赖 agent 的自信总结。
Ожидает перевода
Инженер Cursor Лорен Тан рассказала, как заставляет ИИ-агента самостоятельно отправлять и мержить пул-реквесты. Главное здесь — умение проверять: агент сам запускает код, снимает CPU-трейсинг и открывает симулятор iOS, чтобы убедиться, что работа сделана правильно.
Почему это важно: Инженеры Cursor разложили доверие к ИИ-агенту на переиспользуемые проверочные Skill'и, feature map и evals — по этой схеме читатели могут выстроить собственный процесс автоматической проверки.
作者 Johnny Butler 认为,如果编码智能体直到 CI 阶段才发现自己违反了工程规范,反馈就来得太晚,应在智能体实现过程中就运行检查。他建议把测试、linter、类型检查、安全扫描以及团队自定义的依赖规则和复杂度阈值检查交给智能体,让它改完小改动后运行相关检查、修复失败项再重跑,并把结果随代码一起返回,使开发者能用同样的检查复现。
Ожидает перевода
这篇 Claude Code 教程用一个刻意写错的小仓库练习完整控制循环:先以 plan 权限模式让 Claude 只读地梳理仓库、说明测试为何失败并给出验证命令。
Ожидает перевода
作者提出用六段式 spec 模板(Goal、Non-goals、Interfaces、Files、Verification、Budget)向编码智能体描述任务,并配了一个在交给智能体前检查 spec 的 linter。
Ожидает перевода
Почему это важно: 给出可直接套用的六段式 spec 模板、tally 实例和配套 linter,读者能据此改造自己交给编码智能体的任务描述。
作者以 tally 这个 CSV 列统计 CLI 为例,给出从一段式 spec 到可运行工具的完整方法:spec 包含目标、非目标、接口、文件、验证和预算六部分,提示词按先列边界情况、再写九条测试、然后实现、跑三条手工检查、最后按 diff 清单评审的顺序发送。
Ожидает перевода
SWE-bench 的百分比是智能体编程领域被引用最多的数字,但它比通常被引用的方式要窄得多。文章拆解了一次评测如何产出这个数字:提交是 JSONL 格式的补丁,在 Docker 容器中应用到 base_commit 并运行仓库测试,FAIL_TO_PASS 全部通过且 PASS_TO_PASS 不回归才算 resolved,默认是 pass@1。
Ожидает перевода
作者给出一份按危害排序的十项 agent diff 检查清单,依次看被删除的测试、被跳过或弱化的断言、宽泛异常捕获、新增依赖、任务范围外文件、CI 配置改动、疑似密钥、遗留标记和净删除超过 40 行的文件。
Ожидает перевода
Почему это важно: 给出按危害排序的十项 agent diff 检查清单,并附可复用的扫描脚本与行号定位。
作者给出用编码智能体重构遗留脚本时保持行为不变的规则:同一套 characterization 测试通过 mixin 同时绑定旧实现和新实现,任何输出字节变化都会让新实现一侧变红。
Ожидает перевода
文章梳理了 Claude Code、mini-swe-agent、Omnigent 等 harness 提供的硬性停止条件,包括步数、花费、墙钟时间、连续格式错误和显式退出,并建议优先设置美元上限,因为它是唯一随模型规模变化的限制。
Ожидает перевода
文章主张让 AI 智能体在写实现前先展示一次失败的测试,因为一次都没红过的测试无法证明它能检测任何行为。作者引用 AgentLens 论文(arXiv:2605.12925)对 2,614 条 OpenHands 轨迹的评测,发现通过轨迹中有 10.7% 属于 Lucky Pass,各模型的幸运通过率在 0.5% 到 23.2% 之间。
Ожидает перевода
作者给出用编码智能体给无测试遗留脚本补特征测试(characterization tests)的五步方法:先在 plan 模式做只读调研,找出模块级状态、print 位置和疑似 bug。
Ожидает перевода
Автор построил в Codex с помощью Astra космическую исследовательскую игру Void Explorer — с 2,048 звёздными системами и более чем 10,000 процедурно генерируемыми планетами — и рассказал о полном процессе: от промпта до архитектуры, тестирования и измерения производительности.
Почему это важно: Автор использовал Astra в Codex, чтобы сделать полноценную игру, и показал переносимый процесс совместной работы — от промпта до тестирования и измерения производительности.
Автор mattpocock выложил набор AI-агентных Skills, которыми сам пользуется каждый день. Они рассчитаны на реальную инженерию, а не на вайб-кодинг: маленькие, легко правимые, комбинируемые и совместимые с любой моделью.
Почему это важно: Автор разложил многолетний инженерный опыт на набор комбинируемых Skills и для каждого описал, от какого сценария отказа он страхует, — по этому описанию читатель может решить, встроятся ли они в его процесс разработки.
作者设计了一套可复现的对比方法,让 Codex 和 Claude Code 在同一个仓库、同一任务契约、同一权限和停止条件下完成五项任务:仓库发现、编辑纪律、测试恢复、评审证据、远程或无人值守执行。
Ожидает перевода
这个插件把 Birgitta Boeckeler 在 martinfowler.com 提出的 harness engineering 落地为可安装工具,用确定性工具、智能体评审和周期性熵检查约束 AI 生成的代码。
Ожидает перевода
博主用 Qwen3-30B-A3B-Instruct-2507 在租用的 H200 上生成 30 条回答,其中部分用 SynthID-Text 加水印,让读者分辨哪条被水印。首轮 278 人平均得分 3.92/10,重排题目后 73 人平均 3.4/10,接近纯随机猜测的 3.33,说明读者无法识别水印。目前测验累计约 4700 份回答,均值 3.44/10。
Ожидает перевода
OpenAI представила Daybreak — набор инструментов для защиты, объединяющий ChatGPT, Codex Security и открытый CLI Codex Security. Он покрывает проверку пул-реквестов до слияния, разбор репозиториев и накопившихся уязвимостей, а также регулярные проверки в CI.
Почему это важно: В официальной документации описан полный сценарий работы с Codex Security — от проверки пул-реквестов и сканирования репозиториев до пакетного сканирования через CLI. По нему можно понять, как встроить инструмент в существующие процессы безопасности.
Simon Willison 用 Claude Code for web 做了一个约 150 行、零依赖的 TypeScript 服务原型,基于 Bun 1.4 实验性的 Bun.WebView 提供 shot-scraper 风格的 JSON API,支持执行 JavaScript 和输出 PNG/JPEG/WebP 截图,无需 Puppeteer 或 Playwright。
Ожидает перевода
作者提出在 Cursor 中开多个 Agent 窗口只是并行对话,真正要解决的是分工与可检查产物:先用验收卡把需求写成含用户结果、范围、验收标准、所需证据和风险边界的契约,再按 PM、DEV、OPS、QA、EVAL 和人工发布决策划分职责,各自不得替代他人判断。
Ожидает перевода
За шесть месяцев Lovable перевела lovable.dev с месячной аудиторией 4200 на собственный хостинговый стек TanStack Start. Во время миграции оба фреймворка работали параллельно: прокси-воркер распределял трафик по маршрутам и пользователям. В итоге на код, специфичный для Next.js, осталось всего 3%.
Почему это важно: Lovable официально разобрал, как перенёс 90 тысяч строк кода с Next.js на собственный стек TanStack Start: детали параллельной работы двух фреймворков, массовой миграции силами ИИ-агентов и одного инцидента с переполнением памяти можно смело перенимать.
Wiz 红队智能体利用 Snowflake 开源仓库 GitHub Actions 工作流中的命令注入漏洞,从 CI/CD 环境窃取 Jira API 凭证,这些凭证可读取 Snowflake 工程、安全合规和漏洞赏金数据库。
Ожидает перевода
Эдди Османи рассказывает, как каждый день параллельно запускает от 5 до 10 ИИ-агентов, обычно не больше 5 одновременно, и раскладывает циклическую инженерию на два примитива Claude Code: goal доводит одну ограниченную задачу до проверяемого критерия завершения, а loop с фиксированным интервалом перезапускает промпт, как cron.
Почему это важно: Автор разбирает свою повседневную практику параллельного запуска от 5 до 10 ИИ-агентов на два примитива — goal и loop — и показывает, как писать переиспользуемый Skill проверки и условия остановки.
作者结合 Birgitta Böckeler 关于 TDD 的争论,分享了自己在 AI 智能体开发循环中的实践:当问题无法提前清晰定义时,TDD 最有用。他会像结对编程一样贴近智能体,先写一个早期测试、做小改动并观察反馈,这些测试能暴露初始需求中难以察觉的假设。等问题清晰后,他再退后让智能体完成更多实现,最后回来审查代码、运行检查并验证结果。
Ожидает перевода
Augment Code расширил свою систему ревью Cosmos с код-ревью до полного замкнутого цикла от PR до слияния, добавив четыре возможности: Verifier, PR Fixer, Review Dashboard и cosmos approve. За анализ рисков, построчную проверку корректности, ревью дизайна, проверку во время выполнения и исправление отвечают отдельные специализированные эксперты.
Почему это важно: Augment расширил код-ревью до замкнутого цикла от PR до слияния, охватывающего исправление, проверку и согласование, — читатели могут оценить, как на практике распределяются роли между несколькими ИИ-агентами.
有开发者指出,AI 只提升了写代码的速度,但正经公司里 90% 的时间花在跨部门协调、审批和排期上,效率提升非常有限。他举例称一个涉及三个部门、5 个系统的紧急需求,光沟通协调就耗掉三天,最后自己只加了三行配置。另有开发者称,20-30 人的团队如今 3 人加 5 个 Claude 200 刀账号就能同时接 20 个项目。
Ожидает перевода
Martin Fowler 用 Sonnet 4.6 生成、Opus 4.8 盲评的方式,对小型、中型和较大型三类业务逻辑任务分别跑 TDD 与非 TDD 方案,结论是两者质量没有明显差异,非 TDD 方案在设计和测试质量上还多次略高,变异分数也没有实质差别。
Ожидает перевода
Почему это важно: 作者用同一批任务对比 TDD 与非 TDD 智能体实现,给出 token 成本与设计质量差异,并反思哪些 TDD 收益在智能体循环里失效。
作者在评审数千个编码 Agent 的改动后发现,过早加入 rescue 块、兜底逻辑和日志,往往说明功能构建顺序错了。Agent 倾向横向铺开数据库、服务、API、校验和 UI,提前设想完整系统,这与 SWE-bench 只衡量补丁能否解决限定问题并通过测试的评估方式相符。
Ожидает перевода
Addy Osmani 认为,Agent 每天产生数十万甚至上百万次改动,逐行人工评审已不可行,代码质量要靠在 Agent 周围设置质量门禁来保证。这些约束包括单元测试、属性测试、验收测试、变异测试,以及圈复杂度和行长等代码质量指标,并分布在改动开始前、Agent 工作过程中和能否进入生产三个环节。
Ожидает перевода
Команда платформы Spotify рассказала, как развивался фоновый ИИ-агент для разработки Honk: начав с замены скриптов миграции, его постепенно подключили к сборке и проверке тестами, и темп слияния пул-реквестов вырос с 1000 за 3 месяца до 1000 за 10 дней.
Почему это важно: Команда Spotify разбирает путь Honk от скриптов миграции до фонового ИИ-агента для разработки, уделяя особое внимание тому, как верификация и стандартизация определяют, можно ли сливать сгенерированный код.
tikalk/adlc-team-skills 发布一套 Agent Skills,通过 session_start 钩子注入约一百 token 的团队规则索引,任务匹配时再按需加载完整规则,规则存放在可 PR 评审的 team-ai-directives 仓库中。
Ожидает перевода