 Addy Osmani@addyosmaniОценка ИИ3838
Ожидает перевода
Addy Osmani@addyosmaniОценка ИИ3838Ожидает перевода
 Ben Holmes@BHolmesDevОценка ИИ5858
Ожидает перевода
Cursor выпустил двух ботов — Rollouts и Security Review, доступных для Team и Enterprise.
Почему это важно: Официально описаны процессы мониторинга и проверки безопасности для этих двух ботов — читатели могут оценить, можно ли встроить их в существующий конвейер доставки.
 Boris Cherny@bchernyОценка ИИ5858
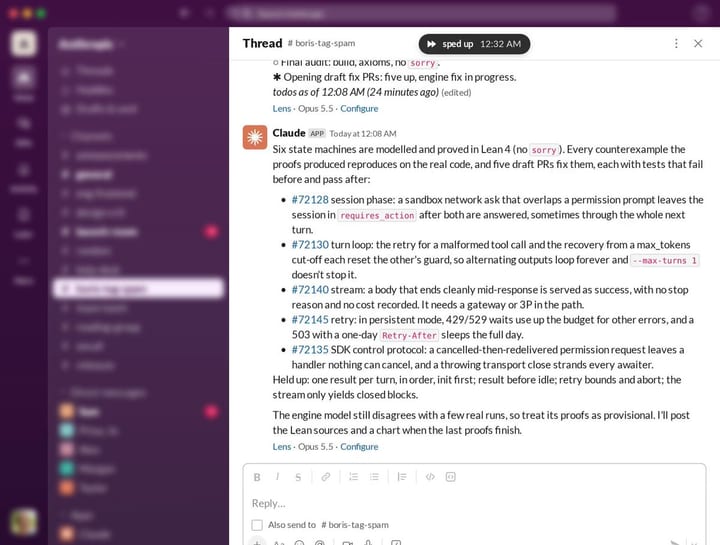
Boris Cherny 用 Opus 5.5 配合 Lean 对 Claude Agent SDK 做形式化验证,几段简短提示词换来 16 个 PR,修复了多个 bug 和竞态条件。
Ожидает перевода
Lovable выпустила Opus 5.5; по заявлению компании, результаты сопоставимы с Opus 5, но число шагов до завершения сократилось на треть–половину. На внутреннем бенчмарке Lovable Opus 5.5 сравнялся с Opus 5 в двух задачах — сборке от 0 до -1 и итеративных правках кода — и превзошёл его на 4%–6% по дисциплине проверки; при всех уровнях интенсивности рассуждений число шагов на задачу снизилось на 26%–57%, а объём входных токенов — на 21%–59%; различия значимы при доверительном уровне 95%.
Почему это важно: Lovable официально приводит данные сравнения Opus 5.5 и Opus 5 по числу шагов и токенов — по ним можно оценить реальное изменение эффективности сборки.
Автор построил в Codex с помощью Astra космическую исследовательскую игру Void Explorer — с 2,048 звёздными системами и более чем 10,000 процедурно генерируемыми планетами — и рассказал о полном процессе: от промпта до архитектуры, тестирования и измерения производительности.
Почему это важно: Автор использовал Astra в Codex, чтобы сделать полноценную игру, и показал переносимый процесс совместной работы — от промпта до тестирования и измерения производительности.
OpenAI представила Daybreak — набор инструментов для защиты, объединяющий ChatGPT, Codex Security и открытый CLI Codex Security. Он покрывает проверку пул-реквестов до слияния, разбор репозиториев и накопившихся уязвимостей, а также регулярные проверки в CI.
Почему это важно: В официальной документации описан полный сценарий работы с Codex Security — от проверки пул-реквестов и сканирования репозиториев до пакетного сканирования через CLI. По нему можно понять, как встроить инструмент в существующие процессы безопасности.
За шесть месяцев Lovable перевела lovable.dev с месячной аудиторией 4200 на собственный хостинговый стек TanStack Start. Во время миграции оба фреймворка работали параллельно: прокси-воркер распределял трафик по маршрутам и пользователям. В итоге на код, специфичный для Next.js, осталось всего 3%.
Почему это важно: Lovable официально разобрал, как перенёс 90 тысяч строк кода с Next.js на собственный стек TanStack Start: детали параллельной работы двух фреймворков, массовой миграции силами ИИ-агентов и одного инцидента с переполнением памяти можно смело перенимать.
Augment Code расширил свою систему ревью Cosmos с код-ревью до полного замкнутого цикла от PR до слияния, добавив четыре возможности: Verifier, PR Fixer, Review Dashboard и cosmos approve. За анализ рисков, построчную проверку корректности, ревью дизайна, проверку во время выполнения и исправление отвечают отдельные специализированные эксперты.
Почему это важно: Augment расширил код-ревью до замкнутого цикла от PR до слияния, охватывающего исправление, проверку и согласование, — читатели могут оценить, как на практике распределяются роли между несколькими ИИ-агентами.
Augment Code предлагает циклический инжиниринг — проектирование цикла ИИ-агента, который охватывает путь от триггера и выполнения до верификации и получения результата: агент берёт на себя промежуточные шаги, а человек подключается только на контрольных точках, где нужно принять решение. В статье циклический инжиниринг сравнивается по уровням с промпт-инжинирингом и контекстным инжинирингом, а также описаны пять стадий — триггер, выполнение, верификация, результат и улучшение — и четыре командных цикла, уже работающих в продакшене: код-ревью, превращение тикета в PR, исправление уязвимостей и реагирование на инциденты.
Почему это важно: Augment Code разбивает циклический инжиниринг на пять этапов — триггер, выполнение, верификацию, результат и улучшение — и приводит четыре командных цикла, уже работающих в продакшене.
Репозиторий skills от AI Hero выпустил v1.1: /to-prd переименован в /to-spec, /to-plan и /to-issues объединены в /to-tickets, а также добавлены новые Skill — /wayfinder, /research, /prototype и другие.
Почему это важно: Автор подробно разбирает весь процесс работы со Skill — от grilling до развёртывания — и приводит команды миграции для переименования, объединения и добавления /wayfinder. Будет полезно тем, кто хочет собрать собственный рабочий процесс для разработки с ИИ.
Terminal-Bench 发布任务设计指南,提出好的基准任务应具备对抗性、难度和可读性:指令像给资深工程师那样清晰直接,测试只验证结果而非实现细节,允许替代解法并防止 reward hacking。难度应来自问题本身,而非苛刻的输出格式或隐藏假设。作者建议亲自运行任务、检查容器、执行 oracle 并观察真实智能体轨迹,失败运行尤其能揭示任务是否真正困难。
Ожидает перевода
OpenAI 用 GPT-5.3-Codex 在 Extra High 推理档下从空仓库连续运行约 25 小时、消耗约 13M token、生成约 3 万行代码,做出一个可测试的设计工具。
Ожидает перевода
Почему это важно: 作者用 25 小时、13M token 的实测展示长时程智能体如何靠持久化项目记忆和逐里程碑验证保持不跑偏。
В блоге разработчиков OpenAI рассказывается, как системно тестировать Agent Skill в Codex с помощью evals и заменить «стало казаться лучше» на сравнимые баллы.
Почему это важно: Полный процесс системной проверки Skill в Codex с помощью eval — от определения критериев успеха до детерминированных проверок и оценки.
OpenAI в Codex Cookbook описывает полный процесс переделки легаси-кодовой базы с помощью Codex CLI на примере системы управления инвестиционным портфелем на COBOL: пять этапов вокруг проектного документа ExecPlan.
Почему это важно: На примере системы управления инвестиционным портфелем на COBOL показаны переиспользуемые документы и процесс проверки для поэтапной переделки легаси-кодовой базы с помощью Codex CLI.
OpenAI Codex Cookbook 给出把 Codex CLI 接入 GitLab CI/CD 的完整做法,用于生成 CodeClimate JSON 代码质量报告、把 SAST 结果整理成 security_priority.md,并让 Codex 输出可 git apply 的补丁。
Ожидает перевода
Почему это важно: 官方 Cookbook 给出把 Codex CLI 接入 GitLab CI 的完整配置,含提示词约束、JSON 标记提取与 diff 校验,可直接照搬。